on
OpenROAD-flow-scripts와 AI Agents로 하루 만에 RTL-to-GDS를 돌려본 후기
최근 WSL 환경을 정리하면서 OpenROAD-flow-scripts(ORFS)와 OSS CAD Suite를 함께 설치해 두었습니다. 이번에는 논문이나 튜토리얼처럼 무언가를 체계적으로 설명하기보다는, AI Agent를 RTL 작성부터 검증, PnR까지 실제 ASIC flow에 붙여보면서 느낀 점을 가볍게 기록해 보려고 합니다.
결론부터 말하면 아직 Commercial EDA를 대체할 수준이라고 보기는 어렵지만, 연구실이나 개인 프로젝트에서 ORFS + Agents 조합이 생각보다 훨씬 강력할 수 있겠다는 인상을 받았습니다. 무엇보다 놀라웠던 것은, 상용 65 nm PDK를 붙이고 Agent가 반복적으로 문제를 수정하도록 만든 결과 하루 정도의 작업만으로 RTL에서 PnR까지 이어지는 flow를 만들어낼 수 있었다는 점입니다.
들어가며
현재 제 WSL 환경에서는 대략 다음과 같이 툴을 구성해 두었습니다.
~/tools
├── OpenROAD-flow-scripts
└── oss-cad-suite
OSS CAD Suite는 RTL 작성과 기본적인 검증에 사용하고, 이후 physical design은 OpenROAD-flow-scripts를 이용하는 구조입니다.
이번 실험의 목적은 단순히 OpenROAD 예제를 한 번 돌려보는 것이 아니었습니다. ORFS는 여러 open-source PDK와 reference design을 기본으로 제공하고 있기 때문에, 사실 그것만 실행하는 것은 크게 어렵지 않습니다.
제가 궁금했던 것은 조금 달랐습니다.
“실제로 Commercial PDK를 붙여도 이 flow가 어느 정도까지 동작할까?”
OpenROAD 프로젝트에서는 advanced node를 포함한 실제 tape-out 사례를 계속 강조하고 있습니다. 그렇다면 legacy node 정도라면 개인이나 연구실에서도 충분히 실용적인 수준으로 사용할 수 있지 않을까 하는 생각이 들었습니다.
그래서 비교적 다루기 편한 65 nm Commercial PDK를 하나 붙여보기로 했습니다.
1. RTL부터 먼저 Agent에게 맡겨보기
ORFS를 만지기 전에 먼저 OSS CAD Suite를 Codex와 연동하여 RTL을 생성하고 검증하는 환경부터 만들어 보았습니다.
Agent에게 단순히 RTL만 작성하게 한 것이 아니라,
- RTL
- Testbench
- Test Vector
- Specification
- Regression
까지 함께 만들도록 했습니다.
최종적으로 만든 RTL에 대해서는 다음과 같은 검증을 수행했습니다.
Verification:

- Icarus/VVP simulation: PASS
- Verilator lint: PASS
- Yosys synthesis: PASS
- Transactions: 50,026 accepted, 50,026 produced
- Arithmetic/protocol mismatches: 0
- Exact four-cycle latency, throughput, reset flushing, signed zero,
  subnormal, special values, rounding boundaries, and required
  regression case verified.
물론 이 정도 결과만으로 RTL의 완성도를 보장할 수 있는 것은 아닙니다. Coverage나 Formal, 더 공격적인 constrained-random verification 등을 추가한다면 훨씬 더 탄탄한 환경을 만들 수 있을 것입니다.
다만 이번 실험에서는 “Agent가 직접 작성한 RTL을 최소한 synthesis 가능한 상태까지 얼마나 빠르게 끌고 갈 수 있는가”를 확인하는 것이 목적이었고, 그 정도 수준에서는 꽤 만족스러운 결과를 얻었습니다.
2. ORFS를 열어보니 AGENTS.md가 있었다
최근 ORFS repository의 구조를 보면 다음과 같이 AGENTS.md가 기본으로 포함되어 있습니다.
.
├── AGENTS.md
├── BUILD.bazel
├── CLAUDE.md -> AGENTS.md
├── Dockerfile
├── Jenkinsfile
├── LICENSE_BUILD_RUN_SCRIPTS
├── MODULE.bazel
├── README.md
├── bazel
├── build_openroad.log
├── build_openroad.sh
├── claude.sh
├── dependencies
├── dev_env.sh
├── docker
├── docs
├── env.sh
├── etc
├── flake.lock
├── flake.nix
├── flow
├── jenkins
├── patches
├── setup.sh
├── tclint.toml
├── tools
└── yamlfix.toml
이걸 보고 가장 먼저 든 생각은 간단했습니다.
“아예 Agent를 적극적으로 활용하면서 flow를 만져보라는 뜻인가?”
물론 AGENTS.md가 존재한다고 해서 ORFS가 곧바로 Agent-native EDA 환경이라는 의미는 아닐 것입니다. 그래도 repository 자체가 대부분 text 기반 configuration과 script로 구성되어 있다는 점은 AI Agent와 상당히 잘 맞습니다.
실제로 이번 작업에서도 이 부분이 꽤 중요했습니다.
3. OpenROAD는 Agent가 읽기 좋은 EDA 환경이었다
제가 지금까지 가장 많이 사용했던 PnR tool은 ICC 계열입니다.
OpenROAD를 사용하면서 느낀 점 중 하나는 전체적인 사용 감각이 ICC보다는 Cadence Innovus에 조금 더 가까워 보인다는 것이었습니다.
특히 library와 technology 정보를 다루는 방식이 text 기반이라는 점이 인상적이었습니다. ICC 계열에서 자주 접했던 binary 형태의 library ecosystem과 비교하면, LEF/DEF/Liberty/TCL처럼 사람이 직접 열어보고 수정할 수 있는 ASCII 기반 파일들이 훨씬 많이 노출되어 있습니다.
이 차이는 사람에게도 편하지만 Agent에게는 더 큰 차이입니다.
Agent는 파일을 읽고,
- 에러 메시지를 확인하고,
- configuration을 추적하고,
- LEF/Liberty/TCL을 수정하고,
- flow를 다시 실행한 뒤,
- 결과를 비교하는
작업을 반복하기 매우 좋습니다.
이번 실험에서 ORFS가 인상적이었던 이유도 OpenROAD 자체의 개별 알고리즘보다 오히려 EDA flow 전체가 Agent가 접근하기 쉬운 형태로 노출되어 있다는 점이었습니다.
4. Commercial 65 nm PDK 붙이기
기본적인 project setup은 ORFS가 제공하는 구조를 그대로 따랐습니다.
주로 config.mk와 여러 TCL script를 이용해 design과 library를 정의하게 됩니다.
저는 ICC 사용 경험은 있지만 OpenROAD를 제대로 사용해 본 경험은 거의 없었습니다. 그런데도 생각보다 setup 시간이 오래 걸리지는 않았습니다.
명령이나 library를 지정하는 방식도 기존 Commercial EDA에서 사용하던 개념과 크게 동떨어져 있지는 않았습니다. Library format 자체는 Innovus ecosystem과 상당히 비슷한 느낌이지만, flow를 구성하는 TCL 문법이나 사고방식은 ICC를 사용했던 사람도 어렵지 않게 적응할 수 있는 수준이었습니다.
그리고 Agent가 중간중간 발생하는 에러를 읽고 configuration을 수정하도록 만들었습니다.
작업 시간은 대략 하루 정도였던 것 같습니다.
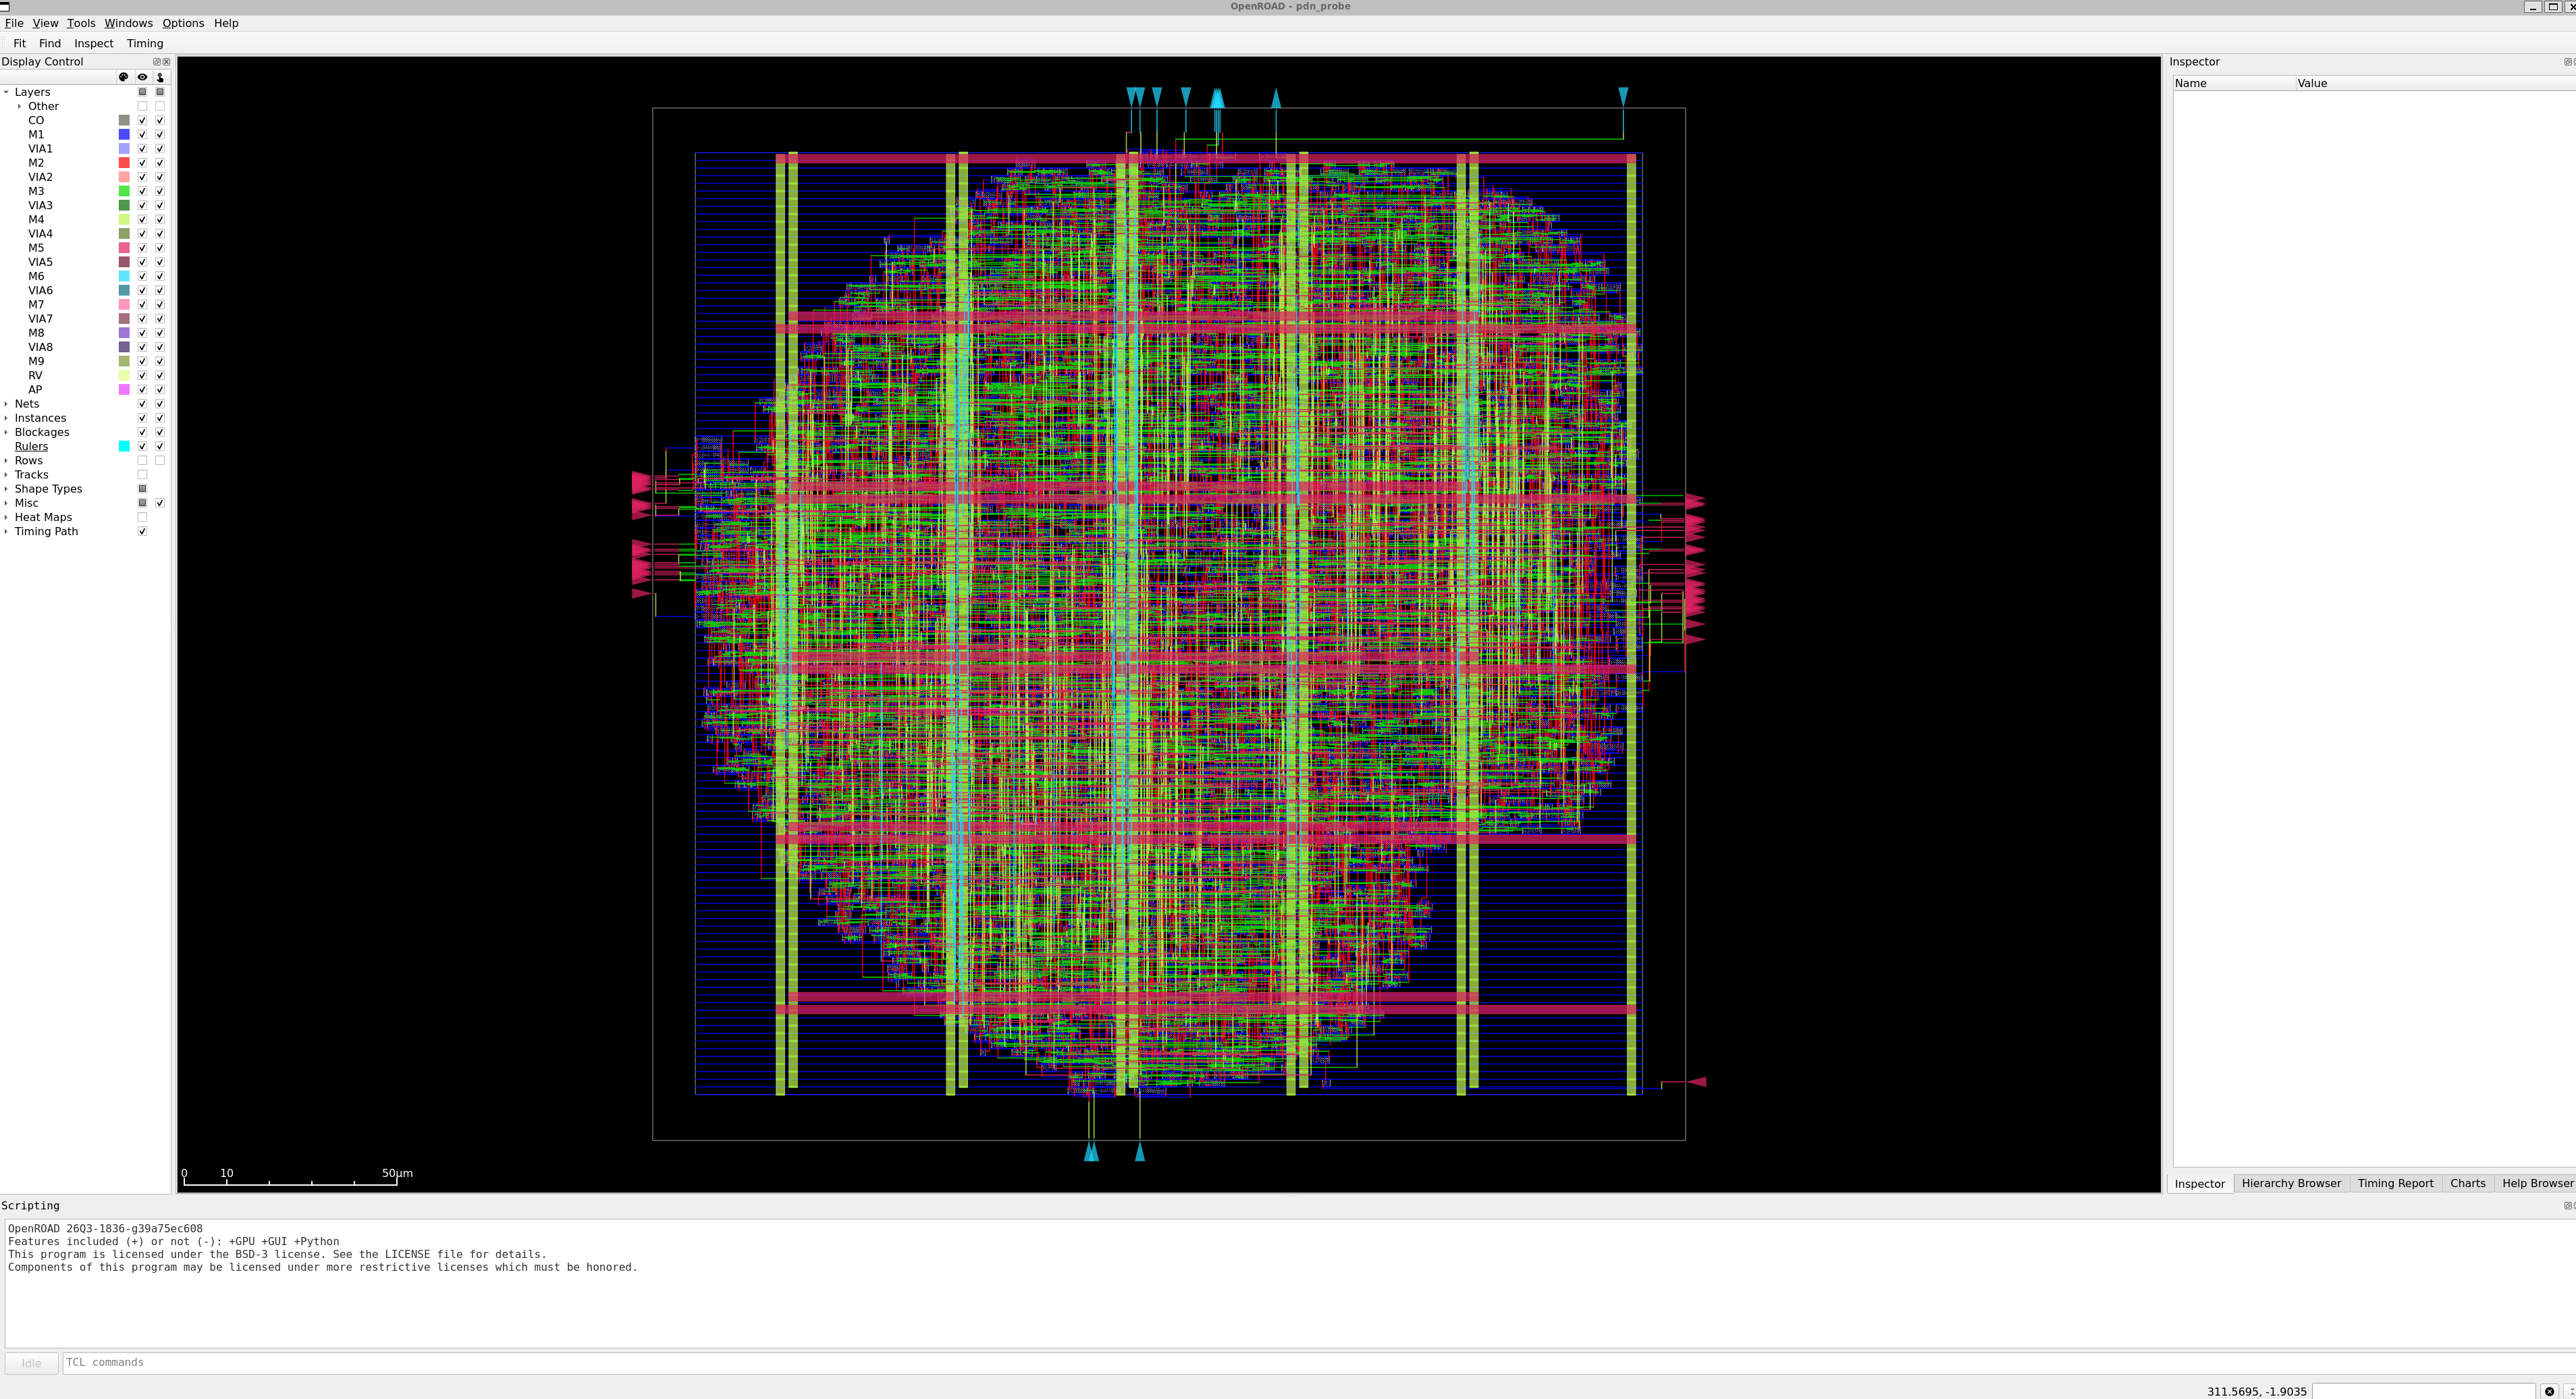
결과적으로 Figure 1처럼 placement, CTS, routing을 거쳐 PnR까지 정상적으로 완료할 수 있었습니다.
물론 “PnR이 끝났다”와 “Tape-out ready다”는 완전히 다른 이야기입니다.
오히려 실제로 flow를 돌려보니 이 지점부터 OpenROAD/ORFS의 장점과 한계가 더 명확하게 보였습니다.
5. 가장 크게 느낀 한계: Sign-off
첫 번째로 느낀 한계는 역시 Sign-off입니다.
Commercial EDA 환경에서는 PDK vendor가 제공하는 technology file과 extraction model을 이용하여 RC를 꽤 정교하게 모델링합니다. 제가 기존에 사용했던 ICC flow에서는 TLU+를 이용하는 경우가 많았습니다.
반면 이번에 65 nm PDK를 ORFS에 붙이면서 구성한 환경에서는 set_layer_rc 등을 이용해 각 routing layer의 resistance와 capacitance를 직접 정의하는 방식이 중심이 되었습니다.
PDK에서 제공하는 captable이나 ICT 계열 정보를 참고하여 값을 옮길 수는 있지만, Commercial extraction flow와 동일한 수준의 model을 그대로 가져오는 것은 쉽지 않았습니다.
즉,
PnR → Parasitic Extraction → Sign-off STA
라는 흐름에서 Parasitic Extraction의 정확도를 어떻게 확보할 것인가가 바로 문제가 됩니다.
ORFS/OpenROAD에서도 이를 보완하기 위한 방법으로 OpenRCX를 제공하고 있습니다. 다만 보다 정확한 extraction rule을 만들기 위해서는 reference SPEF가 필요하고, Commercial PDK에서는 결국 Quantus와 같은 third-party extraction tool을 이용해 reference data를 준비해야 하는 경우가 생깁니다.
이번 실험에서는 여기까지 진행하지 않았습니다.
어차피 목적이 OpenROAD 자체의 Sign-off 정확도를 끝까지 검증하는 것은 아니었기 때문입니다.
6. 아직 Commercial EDA가 필요한 부분들
이번에 제가 확인한 범위에서는 physical implementation을 넘어선 전체 production flow를 ORFS 하나로 완결하기에는 아직 부족한 부분이 많아 보였습니다.
예를 들어,
- Post-layout SDF simulation
- DFT
- ECO
- MMMC
- Sign-off STA
- Sign-off DRC/LVS
- Foundry-qualified RC extraction
등은 Commercial EDA 환경과 비교하면 별도의 보완이 필요합니다.
일부 기능은 OpenROAD ecosystem 안에서도 제공되고 있고 계속 개발되고 있지만, 적어도 제가 이번에 사용한 65 nm setup에서는 “Commercial flow에서 하던 일을 그대로 옮기면 된다”고 말할 정도는 아니었습니다.
특히 연구용 PnR과 실제 Tape-out 사이에는 생각보다 많은 engineering detail이 존재합니다.
그래서 OpenROAD로 routing까지 성공했다고 바로 GDS를 foundry에 던지는 것은 당연히 위험합니다.
7. 예상하지 못했던 문제: 특정 Standard Cell
65 nm library를 붙이는 과정에서는 Standard Cell 쪽에서도 몇 가지 문제가 있었습니다.
일부 Cell의 LEF를 읽거나 PnR 과정에서 처리할 때 에러가 발생했습니다.
정확한 원인을 모두 파고들지는 않았지만, Agent가 flow를 반복 수행하면서 문제가 발생한 Cell을 찾아 자동으로 dont_use 처리하도록 만들었습니다.
재미있게도 이렇게 제외되는 Cell들을 보다 보니 상대적으로 drive strength가 큰 Cell이 자주 걸렸습니다.
결국 사용 가능한 cell set을 조금 제한한 상태에서 flow를 안정화시켰습니다.
이 역시 QoR 측면에서는 당연히 손해입니다.
Commercial tool에서는 멀쩡하게 사용할 수 있는 Cell을 OpenROAD에서는 제외해야 한다면 timing이나 area optimization에서 불리할 수밖에 없습니다.
따라서 다음에 제대로 비교한다면 반드시
동일 RTL + 동일 library + 동일 timing constraint
조건에서 Innovus, ICC, OpenROAD의 결과를 직접 비교해 볼 필요가 있어 보입니다.
Runtime뿐 아니라,
- Area
- WNS/TNS
- Power
- Buffer/Cell count
- Congestion
- Routing quality
정도는 함께 비교해야 의미가 있을 것 같습니다.
8. 그런데도 ORFS + Agents가 매력적인 이유
여기까지 보면 단점만 잔뜩 적은 것 같지만, 개인적으로는 오히려 이번 실험 이후 ORFS를 꽤 긍정적으로 보게 되었습니다.
가장 큰 이유는 너무 단순합니다.
공짜입니다.
이게 생각보다 엄청난 장점입니다.
Commercial EDA에서는 license 때문에 수십 개의 run을 무작정 병렬로 던지는 것이 현실적으로 부담스러운 경우가 많습니다.
하지만 OpenROAD는 환경만 준비되어 있다면 Agent에게 수십, 수백 개의 parameter를 바꾸어가며 실험하도록 만들 수 있습니다.
예를 들어 RM을 잘 만들어 놓고,
utilization
clock period
placement density
buffering
routing adjustment
CTS parameter
macro placement
같은 값을 sweep하면서 QoR을 비교하도록 만들 수 있습니다.
사람이 직접 이 작업을 한다면 굉장히 지루합니다.
하지만 Agent에게는 이런 반복 작업이 오히려 가장 잘 맞는 일입니다.
9. 연구실 Tape-out에서는 꽤 실용적일지도 모른다
양산 제품이 아니라 학교나 연구실 수준의 prototype chip이라면 이야기가 조금 달라질 수 있다고 생각합니다.
예를 들어 앞단의
RTL
 ↓
Synthesis
 ↓
Floorplan
 ↓
Placement
 ↓
CTS
 ↓
Routing
까지는 ORFS와 Agent를 이용해 최대한 자동화하고,
마지막의
Sign-off STA
Sign-off RC Extraction
DRC
LVS
만 Commercial EDA로 수행하는 방식입니다.
충분한 margin을 주고 OpenROAD와 Commercial tool 사이의 오차를 몇 번의 실험으로 characterization해 놓는다면, 작은 연구용 칩에서는 꽤 실용적인 flow가 될 수도 있어 보입니다.
특히 hierarchical design에서는 가능성이 더 커 보입니다.
여러 서버에서 작은 IP를 각각 독립적으로 PnR하고, Agent가 각 block의 constraint와 결과를 관리하도록 만든 뒤 마지막 integration만 별도로 수행하는 식입니다.
제가 보기에는 이런 Bottom-up hierarchical flow + ORFS + Agents 조합이 연구실 환경에서 특히 재미있는 방향입니다.
10. 가장 인상적이었던 것은 OpenROAD가 아니었다
사실 이번 실험에서 가장 놀랐던 것은 OpenROAD 자체의 성능이 아니었습니다.
Agent가 EDA flow를 다루는 속도였습니다.
제가 한 일은 큰 방향을 정하고, PDK와 library가 어떤 구조로 되어 있는지 알려주고, 문제가 발생했을 때 어디까지 우회해도 되는지를 판단하는 정도였습니다.
그 다음부터는 Agent가 log를 읽고, configuration을 수정하고, flow를 다시 돌리고, 실패 원인을 찾는 작업을 계속 반복했습니다.
그 결과 하루 정도 만에 Figure 1까지 갈 수 있었습니다.
이걸 보면서 솔직히 조금 무서웠습니다.
지금은 OpenROAD라서 모든 것이 text로 열려 있고 작업하기 쉬웠다고 볼 수도 있습니다.
그런데 만약 Commercial EDA 환경까지 Agent가 자유롭게 사용할 수 있고, 여기에 3개월 정도 시간을 주어 RTL-to-GDS automation flow를 제대로 만든다면 어느 정도까지 갈 수 있을까요?
Synthesis script 작성, constraint tuning, floorplan exploration, PnR parameter sweep, STA 분석, ECO 반복까지 사람이 매번 직접 하던 작업 중 상당 부분이 자동화될 가능성이 있어 보입니다.
마무리
현업에서는 이미 거의 모든 직무에서 AI Agent를 적극적으로 사용하기 시작했습니다.
그렇다면 학교나 연구실에서도 논문 검색이나 코드 작성 정도에만 AI를 사용하는 것이 아니라, 실제 EDA workflow 자체를 Agent와 결합하는 시도를 해볼 필요가 있다고 생각합니다.
ORFS는 아직 Commercial EDA를 완전히 대체할 수 있는 툴은 아닙니다.
특히 Sign-off와 advanced implementation 단계에는 분명한 한계가 있고, Commercial PDK를 붙이면 예상하지 못한 compatibility 문제도 발생합니다.
그럼에도 불구하고,
“RTL-to-GDS flow를 Agent가 직접 읽고, 수정하고, 반복 실행할 수 있다.”
는 사실 자체가 꽤 큰 변화처럼 느껴졌습니다.
이번에는 하루 정도 장난삼아 만들어 본 flow였지만, 조금 더 제대로 된 Reference Methodology를 만들어 놓고 Agent에게 optimization까지 맡겨보면 꽤 재미있는 결과가 나올 것 같습니다.
그리고 마지막으로 든 생각은 역시 이것이었습니다.
이 속도로 발전하면 과연 내가 살아남을 수 있을까? 😅